關鍵要點
- robots.txt 控制爬蟲能不能檢索網址,想讓網頁不出現在搜尋結果要用 noindex
- Google 只看 user-agent、disallow、allow、sitemap 四個欄位,不支援 crawl-delay
- 改完 robots.txt 先用 Search Console 的 robots.txt 報表確認,Google 最多快取 24 小時
- AI 爬蟲分搜尋用和訓練用,可以分開設定;擋了搜尋用的,就不會出現在該 AI 的搜尋答案
- 網站在 Cloudflare 後面時,防火牆的 AI 封鎖設定也會擋爬蟲,和 robots.txt 是兩回事
Search Console 跳出「遭到 robots.txt 封鎖」,或是聽說要在 robots.txt 擋掉 AI 爬蟲,才發現自己從沒打開過這個檔案。robots.txt 只有幾行字,平常不用管,但寫錯一行就可能讓整個網站從搜尋結果消失;AI 爬蟲出現之後,要不要擋、擋哪一隻,也成了網站主得自己做的決定。
robots.txt 是什麼?告訴爬蟲哪裡能爬
robots.txt 是放在網站根目錄的純文字檔,用來告訴搜尋引擎和其他爬蟲,網站上哪些網址可以檢索、哪些不要檢索。爬蟲是自動瀏覽網頁、收集內容的程式,例如 Google 的 Googlebot;搜尋引擎靠爬蟲把網頁抓回去,才能建立索引、排名,完整流程見搜尋引擎排名怎麼運作。
Google 的說明寫得很直接:robots.txt 主要用來避免網站因為爬蟲要求過多而超載,不是用來讓網頁不出現在搜尋結果(robots.txt 簡介)。
想看自己網站的 robots.txt,在瀏覽器輸入「網域/robots.txt」即可,例如 https://geniushub.cc/robots.txt。幾個基本規則:
- 檔案名稱固定是 robots.txt,一定要放在根目錄,放在子資料夾無效
- 每個主機各自獨立:shop.example.com 不會沿用 example.com 的 robots.txt
- 規則是給爬蟲的指示,不是強制封鎖;Googlebot 等守規矩的爬蟲會遵守,惡意爬蟲不一定會
robots.txt 能讓網頁不被搜尋到嗎?不能
robots.txt 只能阻止爬蟲檢索網頁,不能保證網頁不被 Google 索引。被 robots.txt 封鎖的網址,如果有其他網頁連過來,仍可能出現在搜尋結果,只是不會顯示網頁說明。要讓網頁完全不出現在搜尋結果,應該用 noindex 或密碼保護。
這是 robots.txt 常被誤會的地方。Google 不會檢索被 robots.txt 封鎖的內容,但如果從其他網頁的連結發現這個網址,還是可能把網址本身和連結的錨定文字編入索引(robots.txt 簡介)。
| 想達成的事 | 該用什麼 |
|---|---|
| 不讓爬蟲檢索某些網址(後台、站內搜尋結果頁) | robots.txt 的 disallow |
| 不讓網頁出現在搜尋結果 | 網頁加 noindex,或用密碼保護 |
| 多個網址內容重複,指定以哪一頁為主 | canonical 標記,做法見重複內容怎麼處理 |
用 noindex 時有一個前提:網頁不能同時被 robots.txt 擋住。Google 的說明是,noindex 要生效,網頁必須能被爬蟲存取、不能遭 robots.txt 封鎖(使用 noindex 禁止建立索引);擋住了,Google 讀不到 noindex 指令。另外,直接在 robots.txt 裡寫 noindex 也沒有用,Google 自 2019 年 9 月 1 日起已不支援這種寫法(robots.txt 不支援規則的注意事項)。
robots.txt 怎麼寫?四個指令就夠用
Google 支援的 robots.txt 欄位只有四個:user-agent 指定爬蟲、disallow 指定不可檢索的路徑、allow 指定可檢索的路徑、sitemap 填 Sitemap 完整網址。crawl-delay 等其他欄位 Google 不支援。路徑區分大小寫,規則衝突時 Google 採用路徑最長、最明確的那一條。
| 指令 | 作用 | 寫法範例 |
|---|---|---|
| user-agent | 指定這組規則給哪個爬蟲,* 代表所有爬蟲 | User-agent: Googlebot |
| disallow | 不可檢索的路徑,/ 代表整個網站 | Disallow: /wp-admin/ |
| allow | 在被禁止的範圍內,開放特定路徑 | Allow: /wp-admin/admin-ajax.php |
| sitemap | Sitemap 的完整網址,不綁定任何爬蟲 | Sitemap: https://example.com/sitemap.xml |
以萬智匯官網的 robots.txt 為例:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /wp-login.php
Disallow: /wp-register.php
Disallow: /*?s=
Disallow: /*?p=*&

Sitemap: https://geniushub.cc/sitemaps.xml
這份檔案對所有爬蟲生效:擋掉 WordPress 後台、登入與註冊頁,以及站內搜尋結果(?s=)這類沒有排名價值、數量又可能無限增加的網址,再告訴爬蟲 Sitemap 在哪裡。* 代表任意字元,$ 代表網址結尾,兩個萬用字元 Google 都支援(Google 如何解讀 robots.txt 規格)。Sitemap 怎麼產生與提交,見Sitemap 是什麼與怎麼提交。
用 WordPress 的話,網站沒有實體 robots.txt 檔案時,WordPress 會自動產生一份,預設只擋後台 /wp-admin/(WordPress do_robots())。多數 SEO 外掛也能在後台直接編輯 robots.txt。
robots.txt 寫好怎麼檢查?看 GSC 報表
改完 robots.txt,先到 Search Console 的 robots.txt 報表確認 Google 讀得到、沒有錯誤。這份報表會列出 Google 找到的 robots.txt 檔案、上次檢索時間、擷取狀態與剖析問題,也可以在修正錯誤後要求重新檢索(robots.txt 報表)。報表只出現在網域資源,或不含路徑的網址前置字元資源;Search Console 的資源怎麼設定,見Google Search Console 教學。
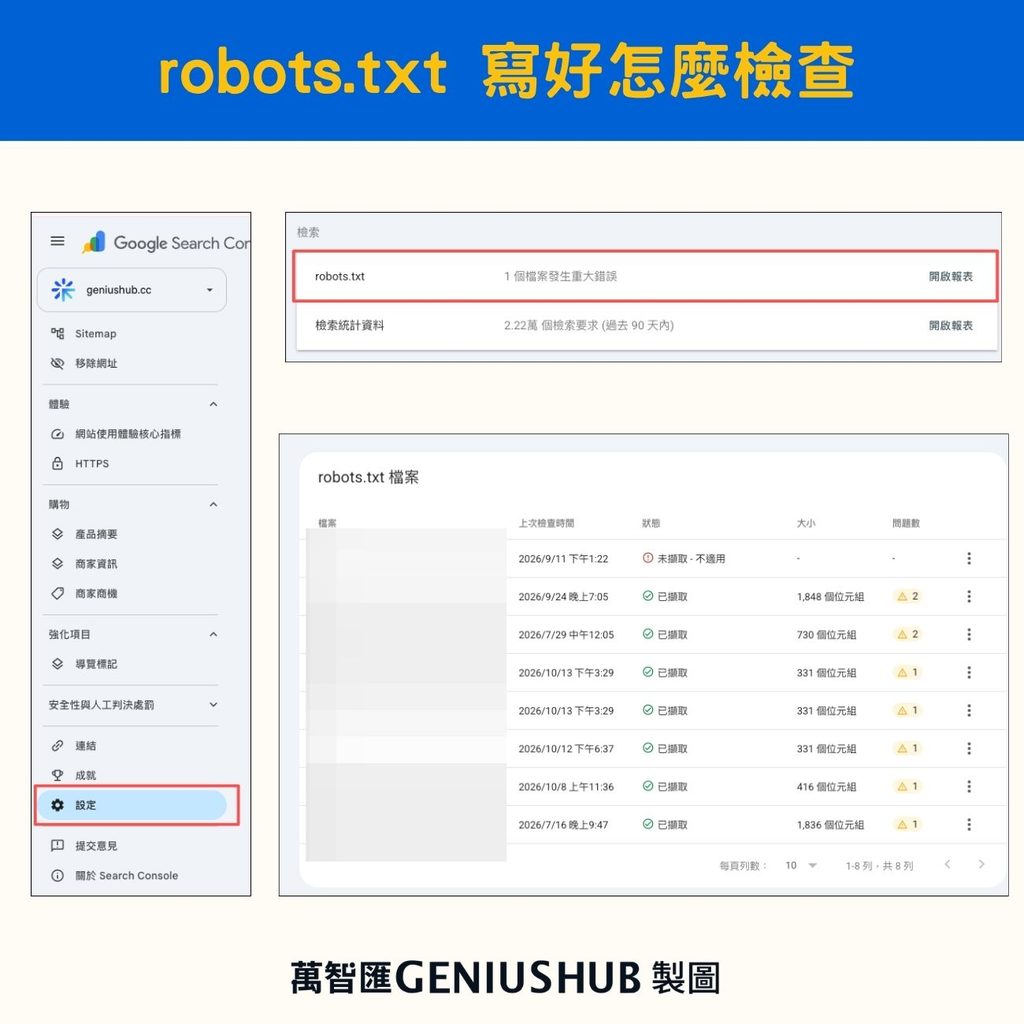
想確認某一個網址有沒有被擋,用 Search Console 的網址檢查工具測試即可。網頁索引報表出現「網址遭到 robots.txt 封鎖」時,處理方式見網站沒被 Google 索引怎麼辦。
💡 萬智匯提提你:Google 通常會快取 robots.txt 最多 24 小時,改完不會立刻生效;解除封鎖重要網址時,可以在 robots.txt 報表點「要求重新檢索」,讓 Google 早點讀到新版本。
robots.txt 常設錯哪裡?整站與資源被擋
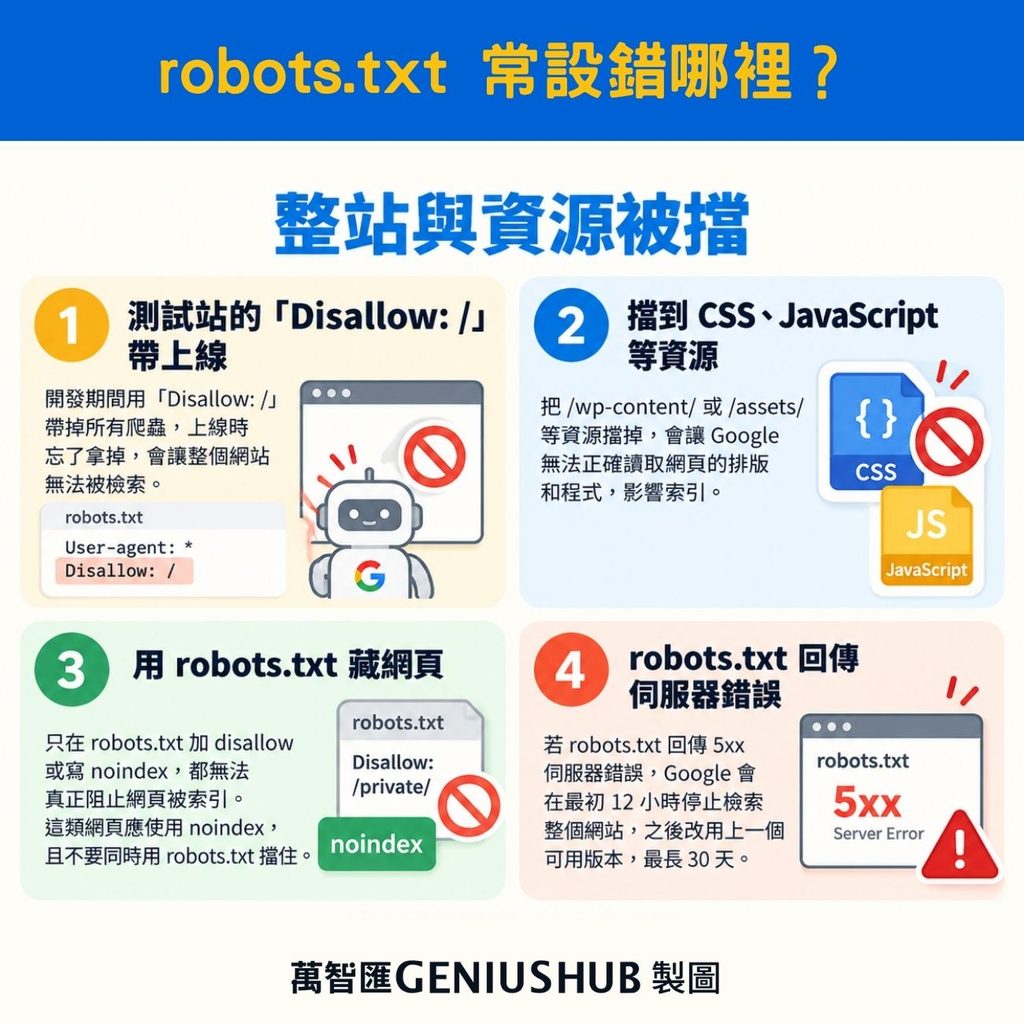
robots.txt 常見的設定錯誤有四種:網站上線時沒拿掉測試期間的「Disallow: /」,讓整個網站無法被檢索;擋到 CSS 或 JavaScript,讓 Google 無法正確解讀網頁;用 robots.txt 隱藏網頁卻沒加 noindex;robots.txt 本身回傳伺服器錯誤,讓 Google 暫停檢索網站。
實際接手中小企業網站時,手動把 robots.txt 設錯其實少見,多半 CMS 預設就處理好了;更常見的是上線前設的 noindex 忘了關,排查方式見網站沒被 Google 索引怎麼辦。真的出錯時,通常是下面幾種。
測試站的「Disallow: /」帶上線
網站開發期間,工程師常用「User-agent: *」加「Disallow: /」擋掉所有爬蟲,避免半成品被搜尋到。改版上線時如果忘了拿掉,等於叫所有搜尋引擎不要檢索整個網站。新站上線或改版後,先打開「網域/robots.txt」確認沒有這一行。
擋到 CSS、JavaScript 等資源
為了省檢索量把 /wp-content/ 或 /assets/ 整個擋掉,Google 就讀不到排版和程式檔。Google 的說明是,如果缺少這些資源會讓 Google 難以瞭解網頁內容,就不要封鎖(robots.txt 簡介)。
用 robots.txt 藏網頁
想讓感謝頁、會員頁不出現在搜尋結果,卻只在 robots.txt 加 disallow,網址還是可能被索引;在 robots.txt 寫 noindex 也沒有作用。這類網頁要用 noindex,而且不要同時用 robots.txt 擋住。
robots.txt 回傳伺服器錯誤
robots.txt 不存在(回傳 404)沒有關係,Google 會視為沒有任何檢索限制。但如果 robots.txt 回傳 5xx 伺服器錯誤,Google 最初 12 小時會停止檢索整個網站,之後改用上一個可用的版本,最長 30 天(Google 如何解讀 robots.txt 規格)。主機不穩或防火牆擋到 Googlebot 時,要優先處理。
AI 爬蟲有哪些?分搜尋用和訓練用
AI 爬蟲依用途分兩種:搜尋用爬蟲(OAI-SearchBot、Claude-SearchBot、PerplexityBot)決定網站能不能出現在 ChatGPT、Claude、Perplexity 的搜尋答案;訓練用爬蟲或標記(GPTBot、ClaudeBot、Google-Extended、Applebot-Extended)決定內容能不能拿去訓練模型。兩種可以在 robots.txt 分開設定。
| 公司 | 搜尋用(擋了就不會出現在該 AI 的搜尋答案) | 訓練用(擋了只是不拿去訓練) | 使用者觸發 |
|---|---|---|---|
| OpenAI | OAI-SearchBot | GPTBot | ChatGPT-User |
| Anthropic | Claude-SearchBot | ClaudeBot | Claude-User |
| Perplexity | PerplexityBot | 官方說明不用於訓練 | Perplexity-User |
| Googlebot(含 AI 摘要、AI 模式) | Google-Extended(只是 robots.txt 標記) | — | |
| Apple | Applebot(也可能用於訓練) | Applebot-Extended(只是 robots.txt 標記) | — |
表格有三個地方容易誤會:
- Google 的 AI 摘要由 Googlebot 處理,不是 Google-Extended。Google 說明,網頁只要已編入索引、符合顯示摘要的資格,就可能出現在 AI 摘要與 AI 模式,控管方式和一般搜尋一樣(AI 功能與您的網站)。Google-Extended 管的是 Gemini 模型訓練,以及 Gemini 應用程式引用網頁內容(grounding),不影響 Google 搜尋的收錄與排名。
- 使用者觸發的爬蟲不一定照 robots.txt 走。使用者請 ChatGPT 或 Perplexity 讀某個網頁時,OpenAI 說明 robots.txt 規則可能不適用,Perplexity 也說明這類要求一般會忽略 robots.txt。
- Applebot 是多用途爬蟲,同時服務 Spotlight、Siri、Safari 的搜尋,抓到的資料也可能用於訓練;只想拒絕訓練,擋 Applebot-Extended 即可,網站仍會出現在 Apple 的搜尋結果。
AI 爬蟲要擋嗎?想被 AI 引用就別擋
想被 AI 引用的網站,robots.txt 不能擋搜尋用的 AI 爬蟲:擋了 OAI-SearchBot、Claude-SearchBot、PerplexityBot,網站就不會出現在 ChatGPT、Claude、Perplexity 的搜尋答案。擋 GPTBot、ClaudeBot 等訓練用爬蟲則不影響搜尋引用,只是內容不會被拿去訓練模型。
前幾年很多網站一律封鎖 AI 爬蟲,主要有兩個原因。一是內容被拿去訓練模型卻沒有回報:OpenAI 在 2023 年 8 月公布爬蟲與封鎖方式後,到 2023 年底,十個國家最多人使用的新聞網站有 48% 封鎖 OpenAI 爬蟲,美國高達 79%(Reuters Institute)。二是爬蟲大量抓取拖累伺服器,曾有文件代管網站被單一 AI 爬蟲一天抓走 10 TB 檔案(T 客邦)。當時 AI 爬蟲幾乎只用於訓練,擋了沒什麼損失。
現在不一樣了。ChatGPT 在 2024 年 10 月推出搜尋功能,Claude、Perplexity 也都靠搜尋用爬蟲找資料、附上來源連結;這時候一律封鎖 AI 爬蟲,會連搜尋用的一起擋掉,等於從這些 AI 的答案裡消失。另一個問題是封鎖清單常常抄錯:曾有大量網站從別處複製清單,擋的是 Anthropic 已停用的舊名稱,真正在用的 ClaudeBot 反而沒擋到。
萬智匯獨家觀點:萬智匯自己兩種 AI 爬蟲都不擋,也建議想被看見的品牌不要擋。搜尋用的擋了,會直接失去被 AI 引用的機會;訓練用的擋了雖然不影響搜尋引用,但 Google-Extended 同時管 Gemini 引用網頁內容,而且 AI 沒上網搜尋時是靠訓練資料回答,我們希望品牌被 AI 認識。
內容本身就是商品的網站,例如付費媒體、會員制內容,可以保留搜尋用、只擋訓練用,寫法如下:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
最後要提醒,robots.txt 沒擋,不代表 AI 爬蟲進得來。網站在 Cloudflare 後面時,後台的 AI 爬蟲封鎖是防火牆層級的設定,和 robots.txt 無關;Cloudflare 2025 年 7 月起,新網站加入時會先詢問要不要允許 AI 爬蟲(Cloudflare 新聞稿),2026 年 9 月 15 日起,選擇封鎖訓練用爬蟲的網站,連 Googlebot、Bingbot、Applebot 這類兼做搜尋與訓練的爬蟲也會一起被擋(Cloudflare 部落格)。用 Cloudflare 的網站,記得到後台確認這項設定。被 AI 引用還需要哪些技術準備,見GEO 怎麼做。
robots.txt 常見問題
每個網站都需要 robots.txt 嗎?
robots.txt 不是必要檔案。網站沒有 robots.txt 時,Google 會視為沒有任何檢索限制,Search Console 的說明也認為這樣沒有問題;用 WordPress 的網站則會自動產生一份預設版本。需要擋後台、站內搜尋結果這類網址,或想告訴爬蟲 Sitemap 位置時,再建立 robots.txt 即可。
robots.txt 改完多久會生效?
Google 通常會快取 robots.txt 最多 24 小時,改完後不會立刻生效;OpenAI 也說明,搜尋用爬蟲大約 24 小時後才會反映 robots.txt 的變更。急著解除封鎖時,可以在 Search Console 的 robots.txt 報表要求重新檢索,但不保證被解除封鎖的網址會立刻重新檢索。
Google 支援 robots.txt 的 Crawl-delay 嗎?
Google 不支援 robots.txt 的 crawl-delay 欄位,寫了會被忽略。其他爬蟲不一定,例如 Anthropic 說明 ClaudeBot 支援 crawl-delay,Apple 則說明 Applebot 不支援。
robots.txt 和 llms.txt 一樣嗎?
不一樣。robots.txt 告訴爬蟲哪些網址可以存取;llms.txt 是 2024 年提出的提案格式,用來給大型語言模型一份整理過的網站重點與連結,沒有封鎖功能(llms.txt 提案)。Google 也說明,網頁要出現在 AI 摘要,除了一般搜尋的技術規定之外沒有其他要求。
總結:robots.txt 寧可少擋,不要錯擋
robots.txt 的任務只有一件:管理爬蟲能檢索哪些網址。多數網站維持 CMS 的預設設定就夠用,真正要防的是錯擋,例如整站被「Disallow: /」擋住、擋到 CSS,或把搜尋用的 AI 爬蟲一起封鎖。改完先看 Search Console 的 robots.txt 報表,用 Cloudflare 的網站再確認防火牆設定,這兩步做完,搜尋引擎和 AI 才找得到你的網站。
萬智匯 SEO 服務的網站技術健檢會一併檢查 robots.txt,讓重要網頁維持在搜尋引擎的檢索範圍內。了解萬智匯 SEO 服務
最後更新日期:2026-10